BlogData RoomsStructure des dossiers d'une data room 2026 (avec modèles pour le M&A, les levées de fonds et l'immobilier)
Structure des dossiers d'une data room 2026 (avec modèles pour le M&A, les levées de fonds et l'immobilier)
·19 min de lecture
Marc Seitz
La structure des dossiers d'une data room est l'organisation hiérarchique des documents au sein d'une data room virtuelle, généralement regroupés en dossiers de premier niveau numérotés (1.0 Corporate, 2.0 Financial, 3.0 Legal, etc.) selon la convention d'index M&A standard. Une bonne structure de dossiers permet aux acquéreurs, investisseurs ou auditeurs de parcourir des milliers de documents sans demander de plan, et c'est le signal le plus visible qu'une data room a été préparée par un professionnel.
Récapitulatif rapide
La structure des dossiers d'une data room est une organisation hiérarchique des documents en dossiers de premier niveau numérotés, dossiers principaux et sous-dossiers, selon l'index M&A standard.
Les quatre dossiers de premier niveau les plus utilisés : Corporate, Financier, Juridique, Opérationnel. Les data rooms M&A complètes ajoutent RH, PI, Fiscalité, Réglementaire et Commercial.
La convention d'index numéroté (1.0, 2.0, 3.0...) est le format dominant en M&A et en private equity, car elle fixe l'ordre de tri sur toutes les plateformes cloud et correspond à l'index des banquiers.
Des cas d'usage différents exigent des structures différentes : les data rooms M&A comptent 8 à 10 dossiers de premier niveau ; celles de levée de fonds, 5 à 7 ; les data rooms immobilières sont organisées par bien ou par actif.
Des conventions de nommage cohérentes (YYYY-MM-DD_DocumentType) améliorent la recherche et évitent les dérives de l'ordre de tri.
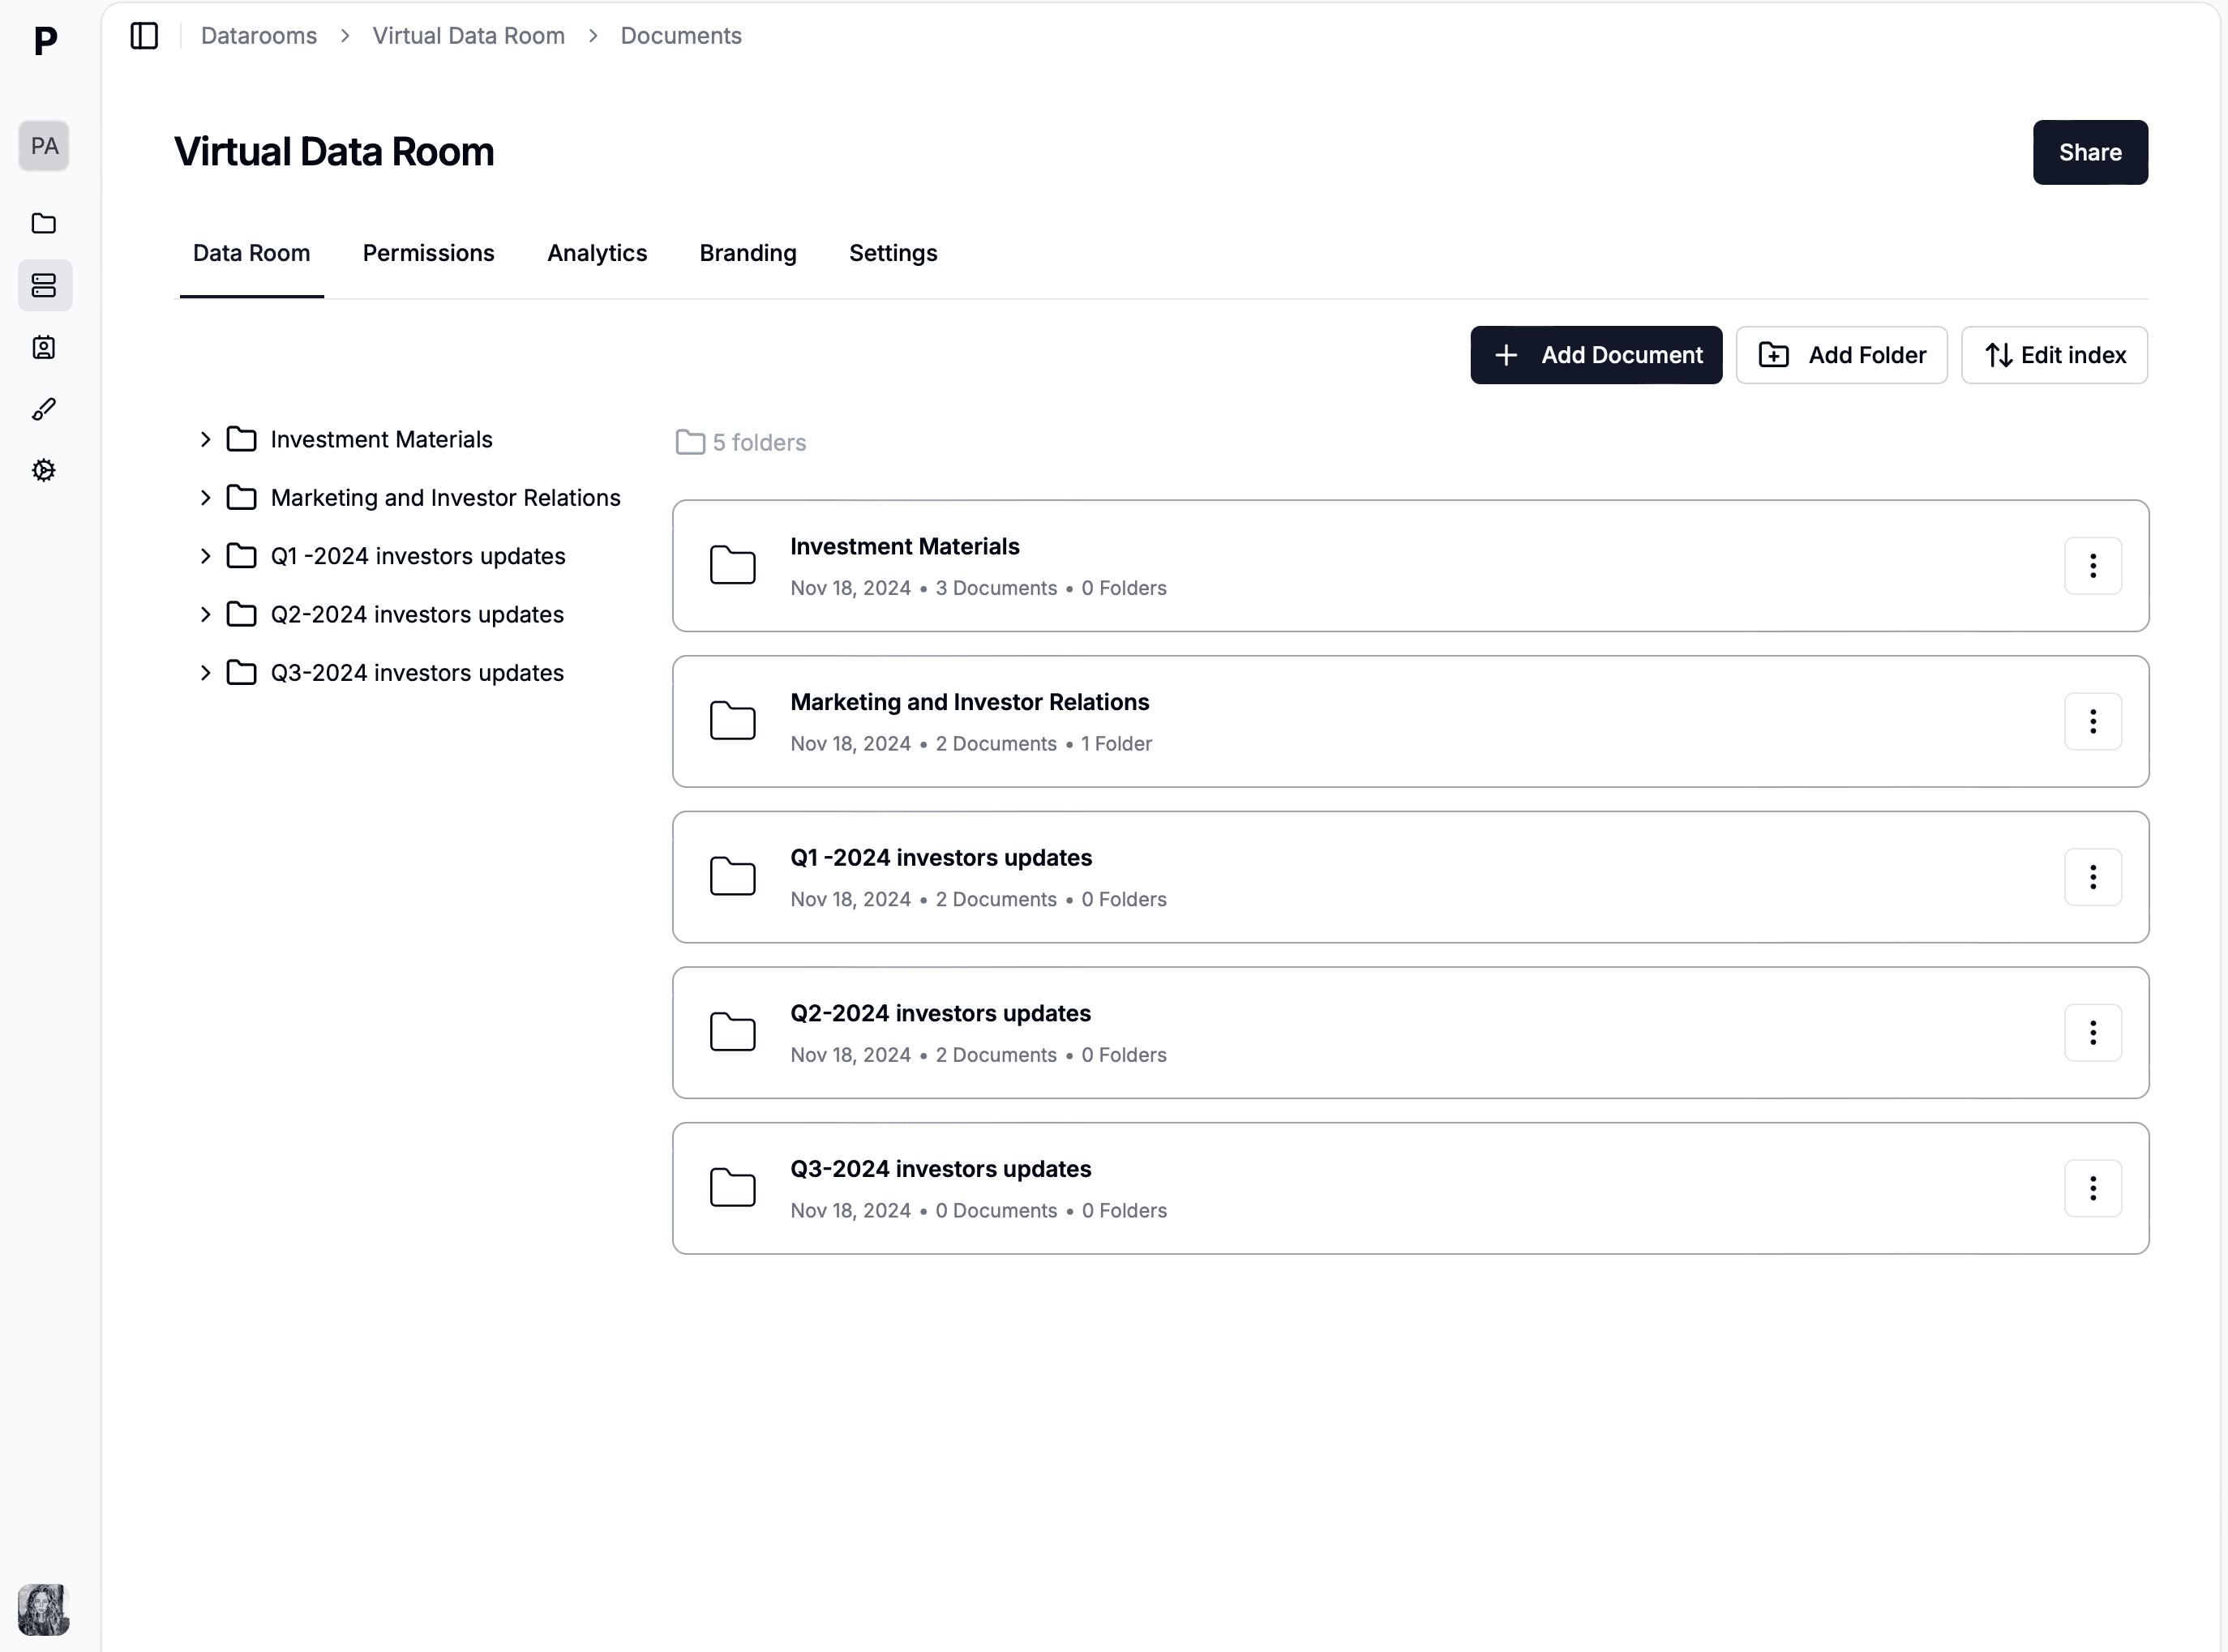
Papermark prend en charge nativement l'organisation des dossiers par glisser-déposer, le chargement en masse avec conservation de la hiérarchie, la recherche en texte intégral et les dossiers de premier niveau numérotés.
L'indexation et les métadonnées (date, auteur, type de document, tags) sont ce qui rend une data room de 2 000 documents navigable sans un banquier au téléphone.
Comment organiser les documents pour une acquisition (7 étapes)
Pour organiser les documents d'une acquisition, constituez une data room unique indexée par catégorie de due diligence, et non par service : des dossiers de premier niveau numérotés pour le corporate, le financier, la fiscalité, les contrats, les RH, la PI et le reste, avec en tête un dossier d'administration de la transaction. Nommez les fichiers avec leur numéro d'index et leur date, ne chargez que les versions finales et définissez l'accès par dossier et par groupe d'enchérisseurs.
Les sept étapes ci-dessous conviennent aussi bien à un vendeur qui se prépare pour les acquéreurs qu'à un acquéreur qui organise ce qu'il reçoit. Elles suivent l'ordre réel du travail, de la liste de demandes de l'acquéreur jusqu'à l'archive au closing.
1. Partir de la liste de demandes de l'acquéreur, pas de votre serveur de fichiers
Votre serveur de fichiers est organisé selon le fonctionnement de votre entreprise : par service, par année, selon la personne qui a enregistré le fichier. Les acquéreurs examinent par chantier. Partez d'une liste de demandes de due diligence standard (80 à 150 éléments est courant pour une transaction du lower mid-market) et laissez chaque demande déterminer l'emplacement de son document.
2. Créer un index maître numéroté
Créez 8 à 13 dossiers de premier niveau numérotés, chacun avec quelques sous-dossiers. Les numéros fixent l'ordre de tri dans chaque navigateur et chaque téléchargement, et permettent à chacun de faire référence au « document 5.1.1 » sans ambiguïté. Le tableau ci-dessous présente un index d'acquisition type ; le modèle d'index de data room le propose sous forme de CSV gratuit avec 97 lignes de documents.
#
Dossier
Documents
1
Administration de la transaction
Index, liste de demandes, journal des questions-réponses, fiche contacts, NDA
2
Corporate et gouvernance
Documents constitutifs, statuts, procès-verbaux, table de capitalisation, organigramme
3
Financier
3 à 5 ans d'états financiers, comptes mensuels, grand livre, relevés bancaires, budgets
4
Fiscalité
3 à 5 ans de déclarations, taxes sur les ventes et sur les salaires, avis
5
Contrats
Contrats clients, fournisseurs et de prêt, avenants
6
Commercial
Liste de clients, chiffre d'affaires par client, churn, pipeline
7
RH et emploi
Registre du personnel, contrats clés, régimes d'avantages, prestataires
8
Opérations et IT
Procédures, systèmes, politiques de cybersécurité, fournisseurs clés
9
Propriété intellectuelle
Enregistrements, cessions d'inventions, licences, noms de domaine
10
Immobilier et actifs
Titres de propriété, baux, registre des immobilisations
11
Assurances, contentieux et conformité
Polices, sinistres, procès, autorisations
12
Dette et fonds de roulement
Lignes de crédit, sûretés, balance âgée clients et fournisseurs
13
Documents de la transaction
LOI, projets de contrat de cession, annexes de divulgation (avocats uniquement)
3. Placer l'administration de la transaction en premier : index, suivi des demandes, journal des questions-réponses, contacts
Chaque acquéreur ouvre d'abord le premier dossier. Faites-en le dossier d'administration de la transaction : l'index à jour, un court fichier « à lire », la liste de demandes avec leurs statuts, l'export du journal des questions-réponses, le NDA et une fiche contacts pour les deux parties. Certains conseils le numérotent 00 pour qu'il apparaisse au-dessus de tout le reste. Si ce dossier est vide, les cinq premières questions que vous recevrez porteront sur l'emplacement des documents.
4. Nommer les fichiers avec numéro, titre et date
Utilisez un seul modèle pour chaque fichier : index number_YYYY-MM-DD_Document-Name_vN, par exemple 3.1.1_2025-12-31_Audited-Financials_v1.pdf. Les dates ISO se trient correctement et se lisent de la même façon dans tous les pays. N'utilisez jamais « final » ou « final-final » dans un nom de fichier. Si un document est encore en cours de collecte, indiquez « En attente » sur sa ligne d'index plutôt que de l'omettre.
5. Ne charger que les versions finales ; garder les brouillons hors de la data room acquéreur
Dès qu'un acquéreur a vu un brouillon avec des chiffres différents, chaque version ultérieure soulève la question de ce qui a changé. Conservez les brouillons dans votre espace de travail interne et ne chargez que des documents finaux et signés. Lorsqu'un document change, chargez-le comme nouvelle version par-dessus l'ancienne afin de conserver l'historique, et indiquez ce qui a changé.
Les acquéreurs qui organisent leur propre côté doivent aussi tenir leurs documents à part. Les documents du vendeur restent dans la data room du vendeur ; les analyses internes de l'acquéreur, les notes de ses conseils et ses constats ont leur place dans un espace de travail interne distinct que le vendeur ne voit jamais.
6. Définir l'accès par dossier et par groupe d'enchérisseurs
C'est l'étape où l'outil compte. Google Drive et SharePoint conviennent pour collecter des documents en interne, mais ils donnent à chaque lecteur externe le même jeu d'autorisations, ne peuvent pas filigraner les pages par lecteur et n'indiquent pas qui a lu quoi. Une data room sécurisée et moderne comme Papermark vous permet de définir l'accès par dossier et par groupe d'enchérisseurs, de protéger chaque lien par un NDA et de filigraner chaque page avec l'e-mail du lecteur et l'heure, avec l'offre Data Rooms à $99/mois.
Groupe
Dossiers
Accès
Administrateur vendeur
Tous
Chargement et modification
Premiers enchérisseurs (avant LOI)
Index 1, synthèses 3 et 6
Lecture seule, avec filigrane
Équipe de l'enchérisseur principal (après LOI)
1 à 12
Consultation et téléchargement filigrané
Clean team
6 détail clients, 7 rémunérations
Lecture seule
Prêteur
3, 4, 12
Lecture seule
Avocats
13
Consultation et téléchargement
Chaque ligne correspond à un groupe ou un lien distinct dans la data room Papermark, de sorte qu'un prêteur ne voit jamais le dossier RH et qu'un enchérisseur ne voit jamais l'activité d'un autre. Les données personnelles, comme la paie par salarié, ont leur place dans un dossier de clean team, anonymisées ou caviardées pour tous les autres.
7. Suivre ce qui manque et ce que lisent les acquéreurs ; archiver au closing
Gardez la liste de demandes à côté des documents afin que les deux parties voient quels éléments sont Ouverts, En cours, Soumis ou Terminés. L'analytique page par page montre quels dossiers chaque acquéreur a ouverts, ce qui vous alerte à l'avance sur la prochaine question. Au closing, gelez la data room (à partir de Data Rooms Plus) pour conserver une archive horodatée avec le journal d'audit et les questions-réponses pendant la période de garantie.
Qu'est-ce que la structure des dossiers d'une data room ?
La structure des dossiers d'une data room est l'organisation hiérarchique des documents au sein d'une data room virtuelle, généralement disposés en dossiers de premier niveau numérotés (1.0 Corporate, 2.0 Financial, etc.) avec des dossiers principaux et des sous-dossiers imbriqués en dessous. Elle est conçue pour permettre aux parties externes (acquéreurs, investisseurs, auditeurs) de parcourir la data room sans demander de plan.
Une structure bien organisée n'est pas décorative. Elle détermine la vitesse à laquelle les acquéreurs avancent dans la due diligence, la lisibilité du journal d'audit après le closing, et si le module de questions-réponses porte sur le fond ou sur la recherche de fichiers. Les anciennes data rooms physiques utilisaient des classeurs de couleur numérotés de 1 à 20 ; les VDR modernes ont conservé la convention de numérotation, car elle fonctionne sur toutes les plateformes cloud et tous les clients de messagerie.
Pourquoi la structure des dossiers compte dans une data room
Une structure de dossiers claire produit trois effets qui influent directement sur le calendrier d'une transaction.
Elle raccourcit les cycles de due diligence. Les acquéreurs qui trouvent par eux-mêmes 80 % des documents standard (états financiers, table de capitalisation, contrats significatifs) ne déposent pas de questions pour ces éléments, ce qui permet à l'équipe transactionnelle de consacrer son temps aux questions de fond plutôt qu'aux chasses au trésor.
Elle permet des autorisations granulaires. Les autorisations au niveau des dossiers ne sont utiles que si les dossiers correspondent à de vraies décisions de périmètre. « 2.1 Audited Financials » peut être ouvert à tous les enchérisseurs tandis que « 2.2 Management Projections » reste réservé à la liste restreinte. Des listes de fichiers à plat rendent cela impossible.
Elle renforce la solidité juridique. Si un acquéreur affirme n'avoir jamais reçu un document, le journal d'audit associé à la structure des dossiers montre ce qui a été publié, quand et qui y avait accès. Une data room désorganisée affaiblit cette chaîne de preuves.
La structure standard des dossiers d'une data room M&A (index numéroté)
L'index M&A numéroté est la convention de fait dans le M&A privé, les levées de fonds de private equity et la plupart des processus de banque d'affaires. Les dossiers de premier niveau utilisent des préfixes entiers (1.0, 2.0...) et les sous-dossiers prolongent la numérotation (2.1, 2.2, 2.2.1). La structure ci-dessous est le cas de base courant en M&A ; les petites transactions suppriment certains dossiers, les grandes ajoutent des catégories propres aux secteurs réglementés.
1.0 Corporate
    1.1 Incorporation documents
    1.2 Bylaws and amendments
    1.3 Shareholder agreements and cap table
    1.4 Board minutes
    1.5 Subsidiaries and org chart

2.0 Financial
    2.1 Audited financial statements (3-5 years)
    2.2 Management accounts
    2.3 Cash flow projections
    2.4 Working capital analysis
    2.5 Capex and opex budgets

3.0 Legal
    3.1 Material contracts
    3.2 Customer contracts
    3.3 Supplier agreements
    3.4 Litigation records
    3.5 Licenses and permits

4.0 HR
    4.1 Employment agreements
    4.2 Organizational chart
    4.3 Compensation and benefits
    4.4 Key-person retention agreements

5.0 IP and Technology
    5.1 Patent portfolio
    5.2 Trademark and copyright registrations
    5.3 IT systems overview
    5.4 Software licenses

6.0 Operations
    6.1 Product and service descriptions
    6.2 Customer lists (scoped)
    6.3 Supplier lists (scoped)
    6.4 Quality control procedures

7.0 Tax
    7.1 Tax returns (3-5 years, by jurisdiction)
    7.2 Tax rulings and correspondence
    7.3 Transfer pricing documentation

8.0 Regulatory and Compliance
    8.1 Regulatory filings
    8.2 Permits and licenses
    8.3 Environmental compliance
    8.4 Privacy and GDPR/HIPAA documentation

9.0 Real Estate and Assets
    9.1 Property deeds and leases
    9.2 Equipment leases
    9.3 Insurance policies

10.0 Strategic
    10.1 Business plan
    10.2 Market analysis
    10.3 Competitive analysis
Pour la correspondance des documents propre à la due diligence, consultez la checklist de la data room de due diligence.
Structure des dossiers d'une data room de levée de fonds (de la Seed à la Série B)
Les data rooms de levée de fonds sont plus légères que les data rooms M&A, car les investisseurs ont besoin d'un ensemble de documents plus restreint et l'entreprise est généralement à un stade plus précoce. Une data room de Seed ou de Série A utilise couramment 5 à 7 dossiers de premier niveau couvrant l'essentiel du pitch.
Structure des dossiers d'une data room immobilière
Les data rooms immobilières s'organisent par actif (un seul bien) ou par portefeuille (plusieurs biens), plutôt que par catégorie de documents. La structure ci-dessous est le modèle de portefeuille utilisé par les fonds immobiliers et les courtiers en immobilier d'entreprise.
Cette structure correspond directement à la façon dont les acquéreurs immobiliers examinent réellement les portefeuilles : ils veulent plonger dans le bien A, comparer ses baux et son NOI à ceux du bien B, puis revenir aux documents communs pour le financement et les données au niveau du portefeuille. Une organisation par catégorie de documents (tous les baux ensemble, tous les rapports environnementaux ensemble) casse ce flux de travail.
Structure des dossiers pour la biotech et les sciences de la vie
Les data rooms de la biotech, de la pharmacie et des dispositifs médicaux ajoutent des couches réglementaires et cliniques à l'index M&A standard. La structure ci-dessous est le modèle que la plupart des conseils en sciences de la vie utilisent pour la due diligence de licences, de partenariats et d'acquisitions en 2026.
1.0 Corporate
1.1 Incorporation and corporate structure
1.2 Cap table and shareholder agreements
1.3 Board minutes and committee resolutions
1.4 Scientific advisory board materials
2.0 Financial
2.1 Audited financial statements (3-5 years)
2.2 R&D budget and burn rate
2.3 Grant funding and non-dilutive capital records
2.4 Pricing and reimbursement strategy
3.0 Intellectual Property
3.1 Patent portfolio (granted, pending, by family)
7.4 External collaboration and academic partnerships
8.0 Commercial
8.1 Market access strategy
8.2 Sales and marketing materials (where applicable)
8.3 Distributor and reseller agreements
9.0 Legal and Compliance
9.1 HIPAA / 21 CFR Part 11 compliance documentation
9.2 GDPR posture for EU clinical sites
9.3 Litigation records
9.4 Material contracts (CRO, CMO, partner)
10.0 HR
10.1 Key-person retention agreements
10.2 Compensation and equity grants
10.3 Organizational chart
Les ajouts propres à la biotech (Réglementaire, Recherche clinique, Fabrication CMC) contiennent généralement les documents les plus sensibles de la data room. La délimitation des autorisations au niveau des dossiers compte ici plus que dans tout autre secteur : un enchérisseur concurrent ne doit pas voir les questions de due diligence d'un autre enchérisseur sur l'IND, et les moniteurs des sites cliniques ne doivent jamais voir la stratégie de prix commerciale. Pour le flux de travail complet d'une VDR biotech, consultez le guide de la data room virtuelle pour la biotech.
Structure des dossiers pour les cabinets d'avocats
Les cabinets d'avocats utilisent deux modèles distincts de data room : les data rooms de mission client (une par dossier) et les data rooms de gestion d'affaires (par dossier contentieux). La structure ci-dessous couvre le modèle M&A et de conseil transactionnel utilisé par la plupart des praticiens du droit.
3.2 Financial diligence (cross-functional with accounting)
3.3 Tax diligence
3.4 Operational and commercial diligence
4.0 Q&A and Working Papers
4.1 Q&A logs by counterparty
4.2 Internal working memos (privileged)
4.3 Drafting comments and redlines
4.4 Closing checklist tracking
5.0 Closing and Post-Close
5.1 Final executed documents
5.2 Closing certificates and officer's certificates
5.3 Wire transfer and escrow confirmations
5.4 Post-close integration materials
6.0 Regulatory Filings
6.1 HSR / antitrust filings
6.2 Foreign investment review filings
6.3 Industry-specific regulatory approvals
Un principe essentiel pour les data rooms de cabinets d'avocats est la délimitation protégeant le secret professionnel. Le sous-dossier « Internal working memos » sous Q&A and Working Papers ne doit jamais être ouvert aux avocats de la partie adverse ni au client, sauf renonciation intentionnelle. Les autorisations granulaires au niveau des dossiers dans Papermark vous permettent de garder ces éléments accessibles à l'équipe transactionnelle tout en les rendant invisibles pour les parties externes.
Comment appliquer les autorisations à votre structure de dossiers
Une structure de dossiers claire n'est utile que si les autorisations y sont appliquées. La stratégie d'autorisations échoue généralement de trois façons : (1) chaque lecteur accède à chaque dossier, ce qui annule l'intérêt des autorisations, (2) chaque lecteur a besoin d'un jeu d'autorisations sur mesure, ce qui rend la data room ingérable, ou (3) l'héritage est mal configuré, de sorte qu'un nouveau sous-dossier hérite involontairement d'un ancien groupe de lecteurs.
Le modèle qui fonctionne pour la plupart des data rooms M&A et de levée de fonds repose sur des autorisations par groupe calquées sur la hiérarchie des dossiers.
Groupe de l'étape 1 (premiers enchérisseurs, 10 à 30 lecteurs) : accès uniquement aux dossiers de premier niveau Présentation de l'entreprise, Faits financiers marquants et Documents marketing. Aucun accès au dossier juridique, aux RH, à la PI ni aux données financières détaillées.
Groupe de l'étape 2 (enchérisseurs de la liste restreinte, 3 à 6 lecteurs) : accès complet aux dossiers de premier niveau Financier, Juridique, PI, RH et Opérationnel. Accès restreint à certains sous-dossiers très sensibles (par exemple, données non caviardées de concentration clients, accords de rétention des personnes clés).
Enchérisseur en phase confirmatoire (enchérisseur final, 1 lecteur + ses avocats) : tout ce que voit le groupe de l'étape 2, plus les éléments retenus que les avocats ont validés pour la divulgation confirmatoire.
Équipe interne (accès administrateur complet) : tout, plus les documents de travail internes, les projets de documents et les notes protégées par le secret professionnel qui ne quittent jamais le cabinet.
Conformité et audit (lecture seule, limitée à certains dossiers) : accès ciblé aux seuls éléments relevant de la conformité, avec une visibilité complète sur le journal d'audit mais sans droit de modification.
Cette matrice des autorisations peut être configurée une seule fois au niveau des groupes plutôt que par lecteur individuel, ce qui rend une enchère M&A à 30 enchérisseurs gérable sur le plan opérationnel. Sans autorisations par groupe, la même configuration exige un paramétrage manuel par lecteur et par document, ingérable au-delà d'environ 10 relecteurs.
Avant et après : un vrai nettoyage de structure de dossiers
Une data room « avant » typique d'un vendeur novice ressemble à ceci :
Documents/
    pitch_deck_v3_FINAL.pdf
    Pitch Deck Final v4 (1).pdf
    finances 2024.xlsx
    legal stuff/
        contracts/
            customer_a.pdf
            customer_b.pdf
        random.pdf
    HR-and-stuff/
        comp.xlsx
        org chart.png
    misc/
        meeting notes.docx
        Q&A.xlsx
Ce qui ne va pas : des fichiers en double (deux versions du pitch deck), des noms de dossiers génériques (« legal stuff », « misc »), des majuscules incohérentes, aucune numérotation de premier niveau, des sous-dossiers qui mélangent des documents sans rapport et un journal de questions-réponses dans un dossier « misc » où les acquéreurs ne le trouveront jamais.
La version « après », réorganisée selon l'index M&A standard :
1. Corporate
    1.1 Incorporation
    1.2 Bylaws and shareholder agreements
    1.3 Cap table

2. Financial
    2.1 Audited financials 2022-2024
    2.2 Management accounts (monthly)
    2.3 Financial model and projections

3. Legal
    3.1 Material customer contracts
        2024-08-15_Customer-A_MSA.pdf
        2024-11-02_Customer-B_MSA.pdf
    3.2 Material supplier contracts
    3.3 IP assignments

4. HR
    4.1 Compensation and equity grants
    4.2 Organizational chart
    4.3 Key employment agreements

5. Operations
    5.1 Product and service descriptions
    5.2 Customer references and case studies

6. Q&A
    (Live Q&A module - threaded by document)
La version propre est navigable dès le premier jour sans un banquier au téléphone, permet au vendeur de délimiter les autorisations au niveau des dossiers et offre aux acquéreurs un espace de questions-réponses qui rattache les questions à des documents précis au lieu de les enfouir dans un fichier Excel au fond d'un dossier « misc ». Même contenu, vitesse de transaction radicalement différente.
Index de data room : la convention des dossiers numérotés expliquée
Un index de data room est la liste numérotée des dossiers de premier niveau et des sous-dossiers qui fait office de « table des matières » de toute la data room. En M&A, l'index est souvent joint au NDA signé ou partagé en aperçu avant l'octroi de l'accès complet, afin que les enchérisseurs sachent ce qu'ils vont voir.
La convention de numérotation fonctionne parce qu'elle fait trois choses que les simples noms ne font pas :
Elle fixe l'ordre de tri sur toutes les plateformes cloud, tous les clients de messagerie et toutes les visionneuses PDF. « 1.0 Corporate » apparaît toujours avant « 2.0 Financial », que le lecteur utilise Google Drive, Papermark ou un ZIP téléchargé.
Elle correspond à l'index du banquier, qui reste la manière dont la plupart des due diligences M&A sont suivies côté acquéreur.
Elle facilite les références dans les questions-réponses : « Question sur le document 3.4.2 » est sans ambiguïté ; « Question sur le contrat » ne l'est pas.
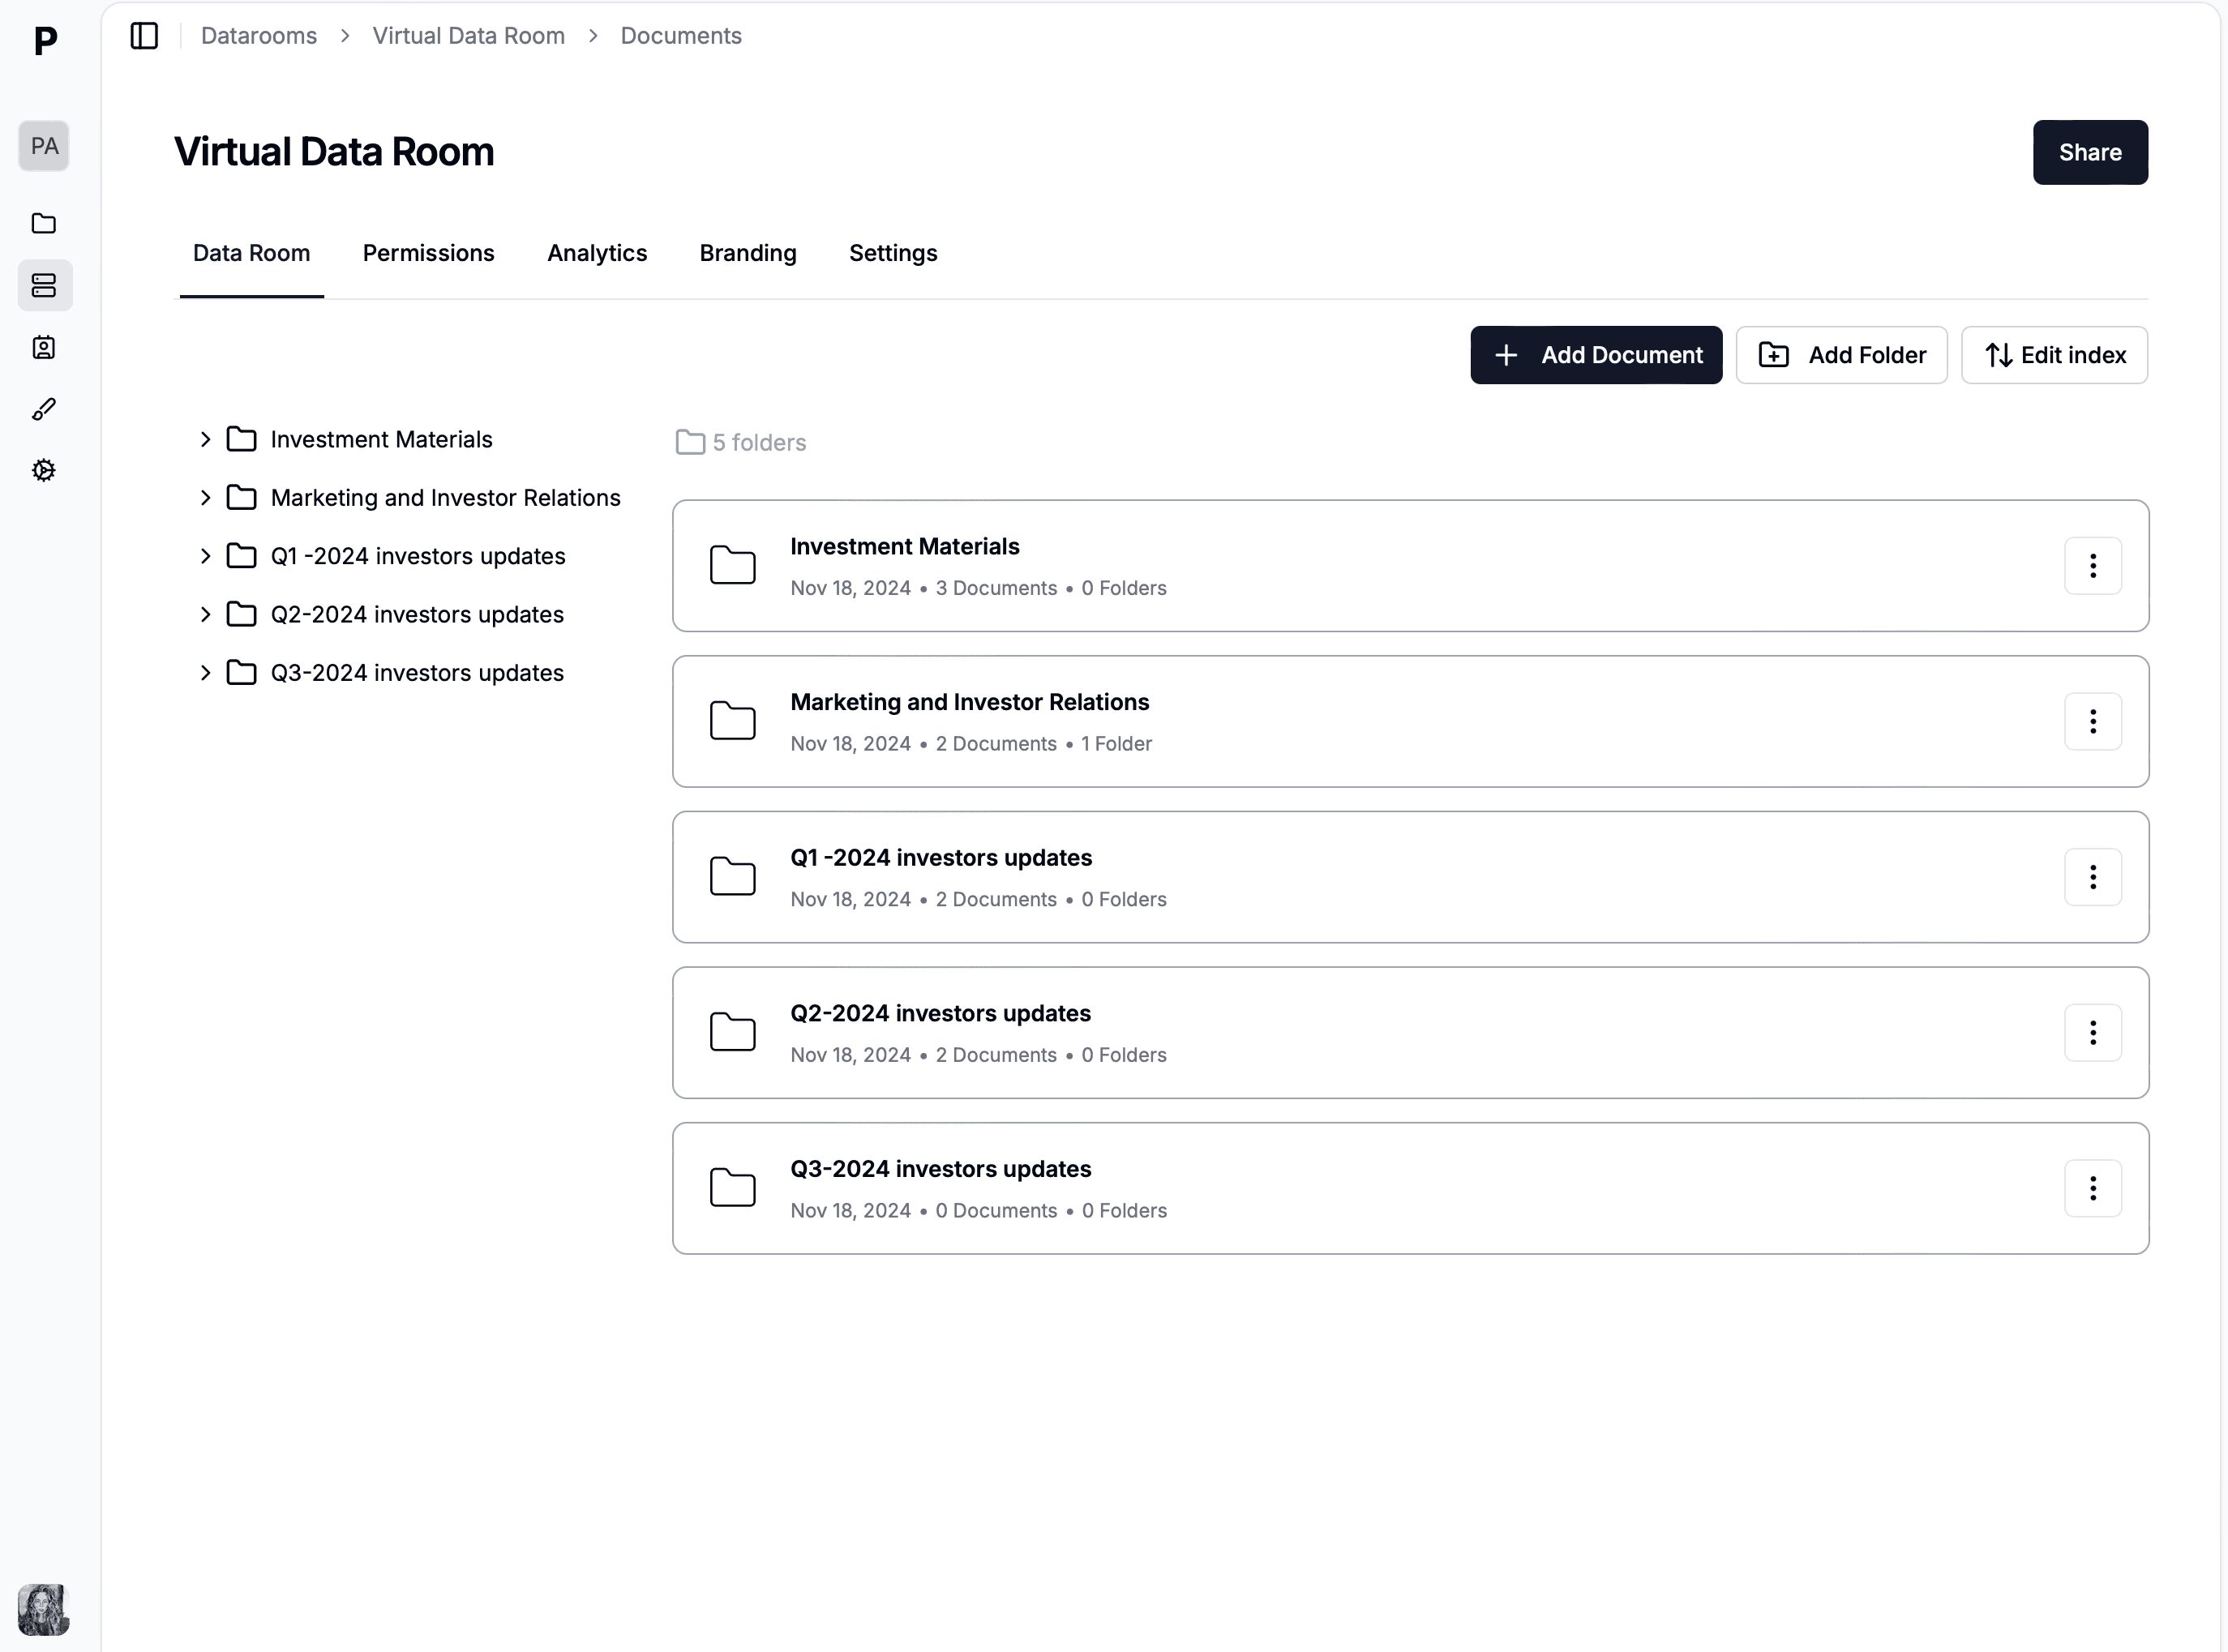
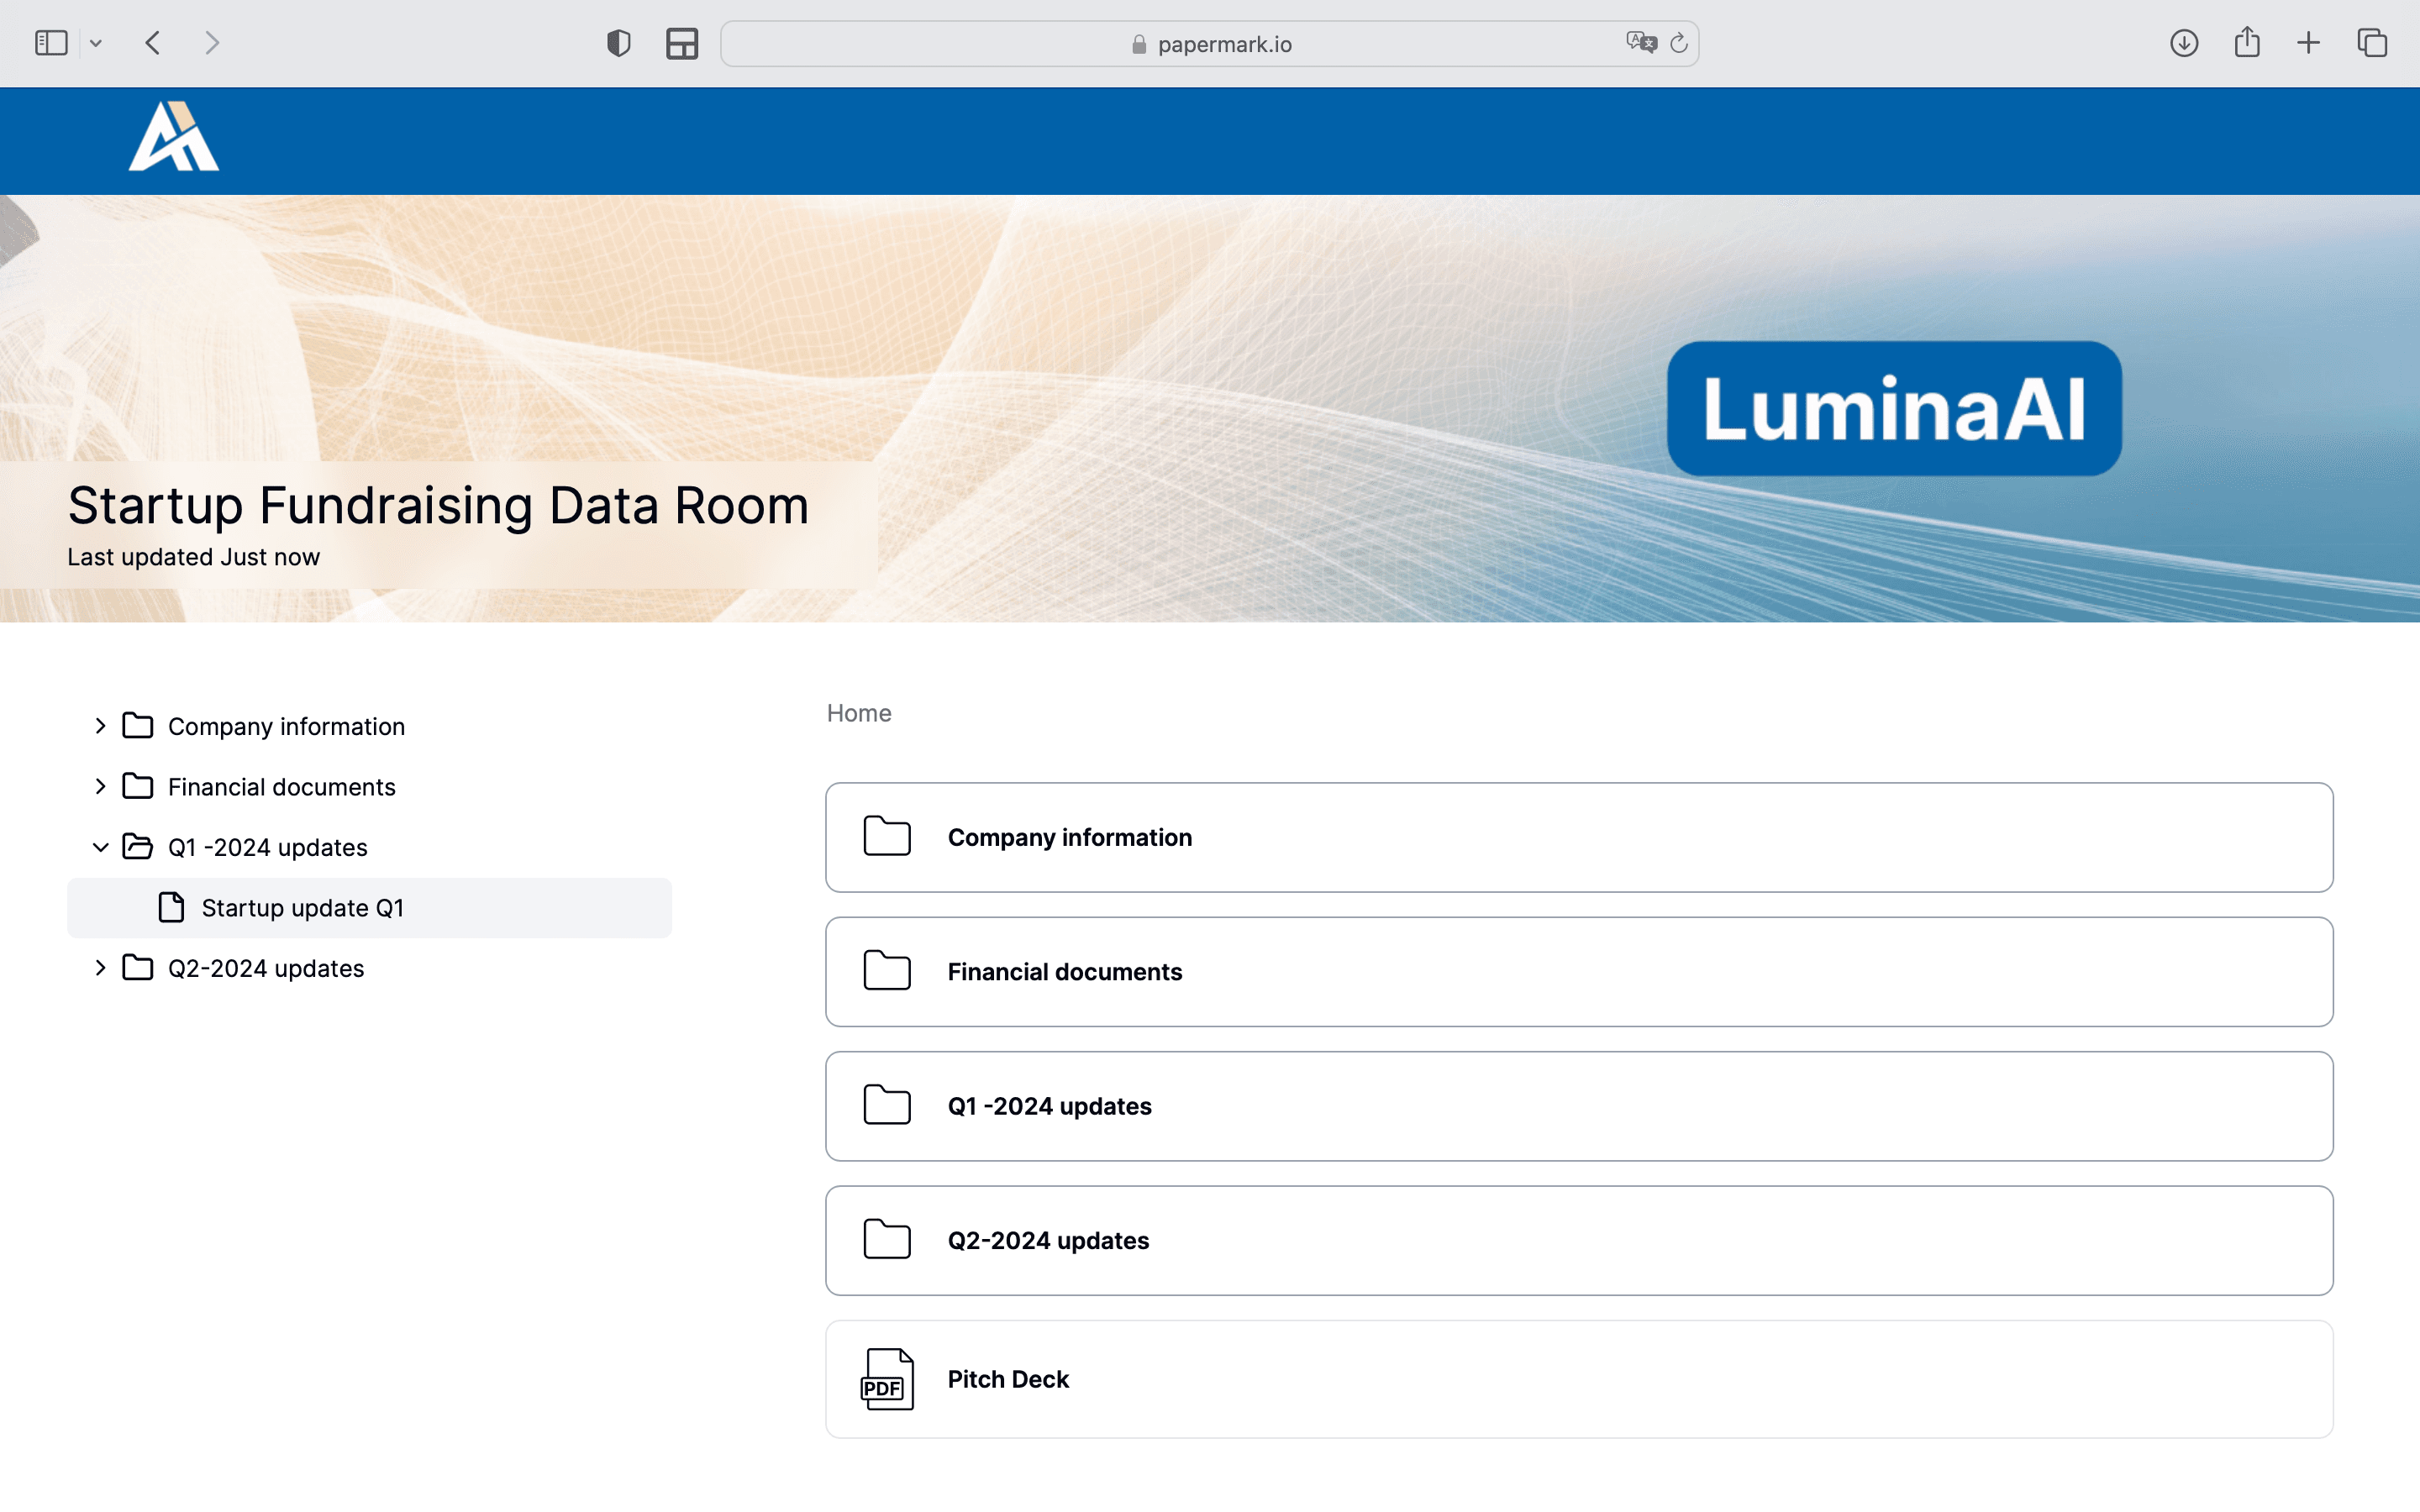
Dans Papermark, les dossiers de premier niveau numérotés s'affichent nativement, et les chargements en masse conservent la numérotation exactement telle qu'elle est structurée en local. L'index lui-même est reconstruit automatiquement lorsque les dossiers sont réorganisés par glisser-déposer.
Conventions de nommage des documents de data room
Les noms de fichiers comptent presque autant que les noms de dossiers. Les deux conventions ci-dessous résolvent 90 % des problèmes de recherche rencontrés dans les vraies data rooms.
Fichiers préfixés par la date :YYYY-MM-DD_DocumentType (exemple : 2026-04-24_Board-Minutes.pdf). Le préfixe de date trie chronologiquement, le type de document se lit d'un coup d'œil et les tirets résistent à l'encodage des URL.
Fichiers avec numéro de version :DocumentType_vN (exemple : Financial-Model_v3.xlsx). À utiliser lorsque l'historique des versions importe plus que la date. Le contrôle de version de Papermark consigne automatiquement chaque révision dans le journal d'audit, si bien que les suffixes de version deviennent moins essentiels au sein de la VDR elle-même.
Évitez les noms génériques (Report, Doc1, Final_FINAL_v2), la casse mixte (Report.pdf et report.pdf posent problème sur les systèmes de fichiers sensibles à la casse) et les espaces dans les noms de fichiers (ils cassent le partage par URL).
Bonnes pratiques d'indexation et de métadonnées
Une fois la structure de dossiers en place, ce sont les métadonnées qui la transforment en archive où l'on navigue par la recherche. Quatre types de métadonnées comptent le plus :
Date du document (non pas la date de chargement, mais celle de création ou d'entrée en vigueur du document)
Type de document (contrat, état financier, politique, certificat)
Juridiction (essentielle dans le M&A multi-pays et la due diligence fiscale)
Tags (étape de due diligence, groupe d'enchérisseurs ou phase de la transaction)
Papermark applique une indexation automatique au fil des chargements et prend en charge la recherche en texte intégral dans le corps des documents (pas seulement dans les noms de fichiers), ce qui permet aux acquéreurs de retrouver des clauses contractuelles ou des postes financiers précis sans savoir dans quel dossier ils se trouvent.
Exemple : l'organisation de la data room d'une société de capital-risque
Découvrez comment Icebreaker.vc structure sa data room pour la communication avec ses LP et la levée de son Fund III :
Erreurs courantes dans la structure des dossiers d'une data room
Cinq erreurs reviennent sans cesse dans les vraies data rooms et font perdre du temps à chaque transaction.
1. Structure à plat, sans hiérarchie. Déposer tous les documents dans le dossier racine, ou dans une liste à un seul niveau, rend la data room impossible à paramétrer et impossible à parcourir pour les acquéreurs. Construisez toujours au moins un niveau de hiérarchie.
2. Numérotation incohérente. Mélanger 1.0 Corporate, Financial, 3.0 Legal casse l'ordre de tri et donne à l'index un aspect amateur. Numérotez partout ou nulle part.
3. Imbrication excessive. Quatre niveaux de sous-dossiers ou plus (2.0/2.1/2.1.1/2.1.1.a) dégradent la navigation au lieu de l'améliorer. Trois niveaux au maximum, sauf pour les plus grandes data rooms M&A d'entreprise.
4. Noms de fichiers génériques.Report.pdf, Final.docx, Doc1.xlsx sont introuvables par la recherche et trahissent une data room préparée à la hâte. Renommez avant le chargement.
5. Aucune délimitation des autorisations. Une data room bien structurée avec une seule autorisation « tout voir » pour chaque enchérisseur passe à côté de l'essentiel. Les autorisations au niveau des dossiers doivent correspondre à l'étape et à la position concurrentielle de chaque groupe d'enchérisseurs.
Comment configurer votre structure de dossiers dans Papermark
Configurer une data room bien structurée dans Papermark prend environ 30 minutes pour une data room M&A ou de levée de fonds standard, à condition que les fichiers soient déjà organisés en local.
Créez la data room et donnez-lui un nom clair (par exemple, « Nom de la société - Due diligence Série B »).
Créez les dossiers de premier niveau selon l'index M&A numéroté (1.0 Corporate, 2.0 Financial, etc.) ou la variante levée de fonds/immobilier ci-dessus.
Ajoutez des sous-dossiers pour les catégories principales (2.1 Audited Financials, 2.2 Management Accounts).
Chargez les fichiers en masse par glisser-déposer ; Papermark conserve la hiérarchie des dossiers de votre système de fichiers local.
Renommez les fichiers selon la convention YYYY-MM-DD_DocumentType s'ils ne la suivent pas déjà.
Définissez les autorisations au niveau des dossiers par groupe d'enchérisseurs ou par rôle de lecteur.
Activez les fonctionnalités de sécurité : filigrane dynamique, NDA obligatoire, vérification de l'e-mail, restrictions de téléchargement.
Testez la structure en ouvrant la data room en tant que lecteur pour vérifier que l'index s'affiche correctement.
Tirer parti de Papermark pour la structure des dossiers de votre data room
Papermark prend en charge nativement l'ensemble du flux de travail lié à la structure des dossiers : dossiers de premier niveau numérotés, réorganisation par glisser-déposer, chargement en masse avec conservation de la hiérarchie, recherche en texte intégral et autorisations au niveau des dossiers. Ces fonctionnalités sont incluses dans l'offre Data Rooms à $99/mois, avec un nombre illimité de visiteurs de data room ; l'indexation automatique des fichiers est disponible à partir de Data Rooms Plus.